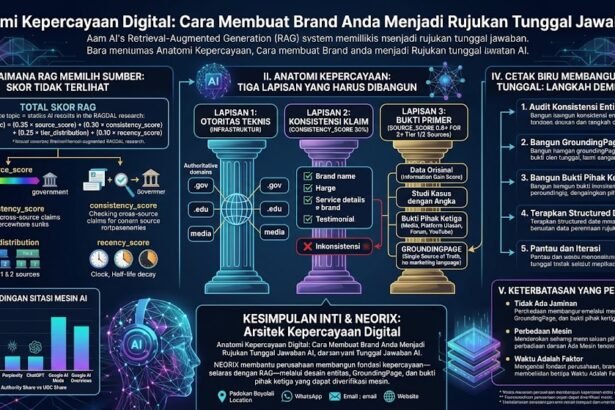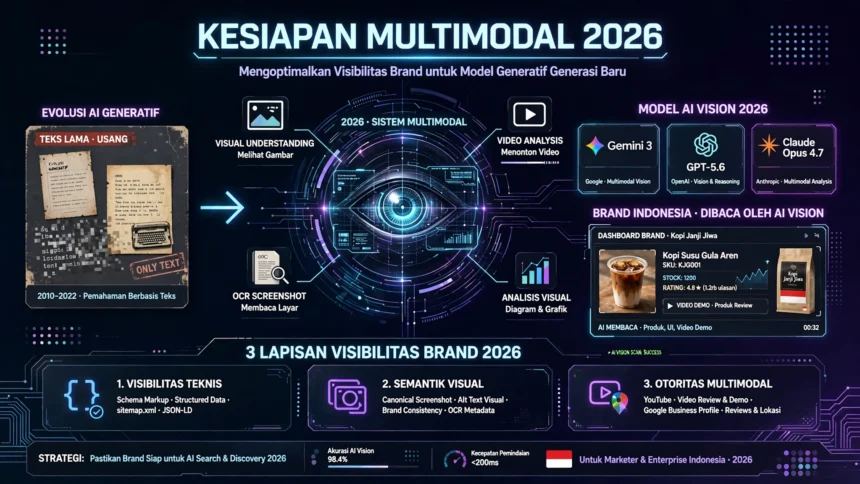
Kesimpulan Inti: Memasuki 2026, mesin AI generatif telah berevolusi dari sekadar pemroses teks menjadi sistem multimodal yang mampu “melihat” gambar, “menonton” video, dan memahami tata letak visual halaman web. Model seperti Gemini 3 dan GPT-5.6 tidak lagi hanya membaca kata kunci—mereka mengekstrak teks dari tangkapan layar melalui OCR, menganalisis bingkai video, dan menilai relevansi visual suatu entitas . Bagi brand di Indonesia, ini berarti strategi AI Visibility (GEO/AEO) yang hanya berfokus pada teks kini menjadi usang. Kesiapan multimodal bukan lagi keunggulan kompetitif—ia telah menjadi syarat minimum untuk muncul dalam jawaban AI generasi baru.
I. Pergeseran Paradigma: Dari Teks ke Multimodal
Model Generasi Baru Tidak Lagi “Buta”
Sepanjang 2025 hingga 2026, garis depan pengembangan model AI telah bergeser secara fundamental. OpenAI, melalui GPT-5.6, memindahkan fokus dari “kecerdasan bahasa” ke “kecerdasan spasial”—kemampuan memahami dan memanipulasi representasi visual dan 3D . Gemini 3 dari Google menempatkan multimodal understanding sebagai salah satu pilar utamanya, dengan performa terdepan pada benchmark seperti MMMU-Pro dan Video-MMMU . Sementara Claude Opus 4.7 dari Anthropic meningkatkan kemampuan visinya secara signifikan, mampu menerima gambar hingga 2.576 piksel pada sisi terpanjang—lebih dari tiga kali lipat model sebelumnya—untuk membaca tangkapan layar yang padat dan diagram kompleks .
Implikasi langsung bagi brand: Ketika pengguna bertanya kepada AI “produk mana yang cocok untuk saya?”, model tidak hanya membaca deskripsi teks produk Anda. Ia menganalisis gambar produk, mengekstrak teks dari tangkapan layar ulasan, dan menonton video demo jika tersedia. Jika aset visual Anda tidak dapat dibaca atau tidak relevan secara semantik, Anda kehilangan titik masuk yang increasingly dominan.
Bukti dari Riset: Caption Injection Meningkatkan Visibilitas
Sebuah makalah yang diterima di ECML PKDD 2026 memperkenalkan teknik Caption Injection—pendekatan multimodal G-SEO pertama yang mengekstrak keterangan dari gambar dan menyuntikkannya ke dalam konten teks . Hasil eksperimen menunjukkan bahwa Caption Injection secara signifikan mengungguli baseline G-SEO yang hanya berbasis teks dalam metrik G-EVAL, meningkatkan visibilitas subjektif konten yang dipersepsikan pengguna .
Ini bukan sekadar temuan akademis. Ini adalah konfirmasi bahwa mesin generatif memperlakukan modalitas visual dan tekstual sebagai sinyal yang saling memperkuat. Brand yang hanya mengoptimasi teks kehilangan separuh dari permukaan serangan.
II. Anatomi Kesiapan Multimodal: Tiga Lapisan yang Harus Dibangun
Lapisan 1: Visibilitas Teknis—Dapatkah AI Membaca Aset Anda?
Sebelum AI dapat memahami gambar atau video Anda, ia harus dapat mengaksesnya. Banyak platform ulasan dan e-commerce merender konten melalui widget JavaScript—format yang dilewati oleh crawler AI . Bazaarvoice, platform UGC dengan 13.000+ brand, meluncurkan paket AI Visibility yang mengonversi rating, ulasan, dan galeri gambar menjadi data terstruktur yang siap-AI. Klien yang menggunakan infrastruktur tersebut melaporkan kenaikan median 40% dalam lalu lintas rujukan yang digerakkan AI .
Yang perlu dilakukan: Pastikan aset visual (gambar produk, tangkapan layar UI, video demo) disajikan dalam format yang dapat diindeks—bukan tersembunyi di balik JavaScript atau player yang tidak mengekspos caption. Schema markup untuk ImageObject dan VideoObject adalah fondasi minimum .
Lapisan 2: Semantik Visual—Apakah AI Memahami Konteks Aset Anda?
Membaca tidak sama dengan memahami. Sebuah gambar produk tanpa keterangan yang bermakna hanya menghasilkan noise. Riset dari roast.page menunjukkan bahwa tangkapan layar kanonik—bukan rendering pemasaran atau ilustrasi 3D abstrak—adalah aset visual dengan nilai tertinggi .
Tiga aturan untuk tangkapan layar kanonik:
- Gunakan konten realistis, bukan placeholder. “Lorem ipsum” dalam tangkapan layar tidak memberikan informasi berguna bagi lapisan OCR. Nama kontak, deskripsi tugas, dan angka yang realistis menjadi bagian dari teks yang dapat diindeks .
- Tampilkan use case, bukan empty state. Papan Kanban yang terisi dengan tugas-tugas realistis menghasilkan embedding visual yang lebih kaya dan lapisan OCR yang lebih berguna daripada papan kosong .
- Sertakan label UI pada resolusi yang terbaca. Jangan kompres gambar secara agresif hingga teks UI menjadi tidak terbaca. OCR gagal pada resolusi rendah .
Keterangan yang ditulis dalam bahasa pembeli, bukan label. Format yang berhasil: “[Siapa] menggunakan [tampilan apa] untuk [mencapai hasil apa].” Contoh konkret: “Dasbor yang dilihat agensi 5 orang saat meninjau laporan retainer bulan ini untuk 14 klien dengan siklus penagihan berbeda.” Ini memberi mesin sinyal bahwa gambar relevan untuk kueri tentang agensi, pelaporan retainer, dan manajemen multi-klien—yang tidak akan muncul dari embedding visual saja .
Lapisan 3: Otoritas Multimodal—Apakah AI Mempercayai Aset Anda?
Gemini 3 secara native terhubung ke ekosistem Google yang hidup—Search, Maps, YouTube, Workspace, dan Merchant Center . Ia “menonton” video YouTube dan “membaca” gambar. Transkrip YouTube diindeks secara agresif. Video how-to dan perbandingan yang menjawab pertanyaan spesifik dalam 30 detik pertama, dengan transkrip atau caption yang akurat, adalah aset multimodal dengan leverage tinggi .
Untuk gambar: Tulis alt text yang mendeskripsikan konteks, bukan hanya penampilan. “Earbuds nirkabel dengan case pengisian 30 jam, rating IPX4” memberi tahu model sesuatu yang tidak akan pernah disampaikan oleh frasa pembaca layar seperti “earbuds hitam” .
Untuk video: Video demo 30–90 detik dengan file caption yang dibersihkan secara manual adalah salah satu aset AEO multimodal dengan leverage tertinggi. Kombinasi video + caption memberi sinyal bahwa halaman menghasilkan bukti experiential, bukan sekadar klaim. Halaman dengan bukti video demo ditimbang berbeda oleh mesin .
III. Lanskap Model 2026: Apa yang Berubah dan Apa Artinya bagi Brand
Gemini 3: Grounding pada Ekosistem Google
Gemini 3 tidak “menciptakan” fakta tentang brand—ia mengambilnya secara langsung dari Google Search, Maps, Merchant Center, dan YouTube, lalu menulis ulang menjadi jawaban . Ini berarti bahwa konten yang sudah dapat ditemukan, diindeks, dan dipercaya oleh Google adalah konten yang dapat dikutip Gemini. Jika brand Anda tidak terlihat di Search tradisional, ia akan tidak terlihat di Gemini .
Pilar multimodal Gemini:
- Video dan gambar dihitung: Gemini dapat “menonton” video YouTube dan “membaca” gambar, serta mengindeks transkrip YouTube secara agresif .
- Google Business Profile dan Merchant Center: Untuk kueri lokal dan entitas, Gemini mengambil langsung dari Google Maps. Lengkapi setiap field dan atribut—jam, kategori, area layanan, foto .
- Structured data dengan
sameAs: Menghubungkan situs, profil sosial, dan halaman Wikipedia/Crunchbase agar Gemini menyelesaikan Anda sebagai satu entitas yang koheren .
GPT-5.6: Dari “Language Model” ke “Executable Agent”
GPT-5.6 telah beralih dari model bahasa menjadi agen yang dapat mengeksekusi tugas. Kemampuan multimodalnya mencakup visual replication, generasi dan manipulasi objek 3D SVG, serta otomatisasi browser melalui Playwright . Dalam pengujian, GPT-5.6 Pro menunjukkan performa yang mendekati model terbatas pada tugas simulasi fisik dan pembuatan renderer WebGL .
Implikasi: Ketika GPT-5.6 dapat “melihat” dan “berinteraksi” dengan antarmuka web, brand yang antarmuka digitalnya tidak dapat dipahami secara visual—tombol yang tidak jelas, alur navigasi yang membingungkan, label yang tidak deskriptif—akan kehilangan peluang untuk direkomendasikan sebagai solusi yang “mudah digunakan” atau “ramah pengguna”.
Claude Opus 4.7: Visi Resolusi Tinggi
Peningkatan visi Claude Opus 4.7 memungkinkan penggunaan yang bergantung pada detail visual halus: agen penggunaan komputer yang membaca tangkapan layar padat, ekstraksi data dari diagram kompleks, dan pekerjaan yang membutuhkan referensi piksel-perfek . Bagi brand yang produknya kompleks—dashboard analitik, alat desain, platform e-commerce dengan banyak SKU—memastikan bahwa tangkapan layar produk Anda dapat dibaca oleh model dengan visi resolusi tinggi adalah keharusan.
IV. Strategi Kesiapan Multimodal untuk Brand Indonesia
Langkah 1: Audit Aset Visual yang Dapat Dibaca AI
Inventarisasi semua aset visual yang mewakili brand Anda: gambar produk, tangkapan layar UI, video demo, infografis, diagram. Untuk masing-masing, tanyakan:
- Apakah aset ini dirender melalui JavaScript yang tidak dapat diakses crawler?
- Apakah ada teks di dalam gambar yang relevan dengan use case? Apakah teks itu terbaca pada resolusi yang disajikan?
- Apakah keterangan yang menyertainya mendeskripsikan konteks dan use case, atau hanya label?
Langkah 2: Terapkan Structured Data untuk Aset Visual
Schema markup untuk ImageObject dan VideoObject memberi mesin deskripsi eksplisit tentang apa itu aset, kapan dibuat, apa yang digambarkan, dan siapa pembuatnya . Ini adalah fondasi teknis yang memungkinkan lapisan semantik di atasnya.
Langkah 3: Bangun “Bukti Multimodal” di Seluruh Titik Sentuh
Semrush, dalam studi AI Visibility Index 2026 yang menganalisis 126 juta kueri, menemukan bahwa ChatGPT sering merujuk ke Reddit, Gemini paling sering mengutip Wikipedia, dan Google AI Mode/AI Overviews paling banyak menggunakan YouTube . Tumpang tindih sumber antara ChatGPT dan AI Overviews kurang dari 56%, dan kutipan bersama kurang dari 50% .
Artinya: Tidak ada strategi universal. Brand harus hadir secara multimodal di platform yang dipercaya oleh masing-masing mesin:
- Untuk Gemini: YouTube (video dengan transkrip), Google Business Profile (foto), Merchant Center (gambar produk dengan data terstruktur) .
- Untuk ChatGPT: Reddit (diskusi komunitas yang otentik), sumber pihak ketiga yang otoritatif .
- Untuk AI Overviews: YouTube, serta konten yang terstruktur dengan baik di web .
Langkah 4: Ukur “Visual Share of Model”
Metrik AI Visibility tradisional mengukur penyebutan teks. Untuk multimodal, diperlukan metrik baru. Targetlytics memperkenalkan konsep Visual Share of Model: (Total Piksel Logo Brand / Total Piksel Semua Logo Kategori) × Skor Keyakinan . Ini memungkinkan brand mengukur seberapa dominan kehadiran visual mereka dalam jawaban AI yang menyertakan gambar—misalnya, ketika pengguna meminta rekomendasi produk dan AI menampilkan carousel dengan gambar.
Pro Tip dari Targetlytics: Tidak semua penyebutan setara. Berikan multiplier 1,5x pada brand Anda jika ia adalah rekomendasi pertama, dan 0,5x jika hanya tercantum di footer “juga pertimbangkan” .
V. Hambatan dan Keterbatasan yang Perlu Diakui
Keterbatasan 1: Crawler AI Masih Tidak Konsisten
Meskipun model telah menjadi multimodal, infrastruktur crawler belum sepenuhnya mengikuti. Banyak platform masih merender konten melalui JavaScript yang dilewati crawler . Brand tidak dapat mengontrol semua platform tempat mereka muncul, tetapi dapat memastikan bahwa aset milik sendiri—situs web, YouTube, Google Business Profile—dapat diakses.
Keterbatasan 2: Tidak Ada Jaminan Hasil
Seperti halnya GEO berbasis teks, tidak ada penyedia yang dapat menjamin bahwa AI akan mengutip atau merekomendasikan brand. Bazaarvoice, misalnya, menyediakan infrastruktur konten dan pengukuran independen melalui mitra seperti Bluefish, Evertune, dan Profound—tetapi tidak menjanjikan hasil spesifik . Klaim harus diverifikasi melalui pengukuran berkelanjutan.
Keterbatasan 3: Biaya Produksi Aset Multimodal
Membuat tangkapan layar kanonik, video demo dengan caption yang dibersihkan, dan structured data untuk setiap aset visual memerlukan investasi waktu dan sumber daya. Ini bukan proyek sekali jalan, melainkan disiplin berkelanjutan.
VI. Rekomendasi: Tiga Prioritas untuk 2026
Prioritas 1: Audit dan perbaiki aset visual yang sudah ada. Sebelum memproduksi konten baru, pastikan bahwa gambar produk, tangkapan layar, dan video yang sudah Anda miliki dapat dibaca oleh AI. Konversi dari JavaScript-rendered ke format yang dapat diindeks, tambahkan keterangan berbasis use case, dan terapkan schema markup.
Prioritas 2: Bangun kehadiran video di YouTube untuk Gemini. Gemini mengindeks transkrip YouTube secara agresif . Video demo 30–90 detik yang menjawab pertanyaan spesifik, dengan transkrip yang bersih dan akurat, adalah aset multimodal dengan ROI tertinggi untuk visibilitas di ekosistem Google.
Prioritas 3: Ukur, jangan berasumsi. Gunakan metrik seperti Share of Model dan pantau sumber kutipan per platform . Tanpa baseline dan pengukuran berkelanjutan, Anda tidak akan tahu apakah upaya multimodal berhasil atau hanya menghabiskan anggaran.
Catatan: Artikel ini disusun berdasarkan dokumentasi resmi model (AWS, Anthropic, Google/Replicate), riset akademis (ECML PKDD 2026, arXiv), serta laporan industri (Bazaarvoice, Semrush, Targetlytics). Klaim tentang hasil spesifik berasal dari sumber yang tercantum dan belum diverifikasi secara independen. Tidak ada penyedia yang dapat menjamin posisi di jawaban AI karena algoritma model bersifat probabilistik dan berubah-ubah.